Table des matières
Préambule
Les LLM n'ont PAS de QI
Je vais commencer très mal : l'idée même de faire passer un test de QI à un LLM est absurde.
En effet pour posséder un "quotient intellectuel", il faut être doté d'intelligence.
Or l'intelligence, jusqu'à récemment et malgré une grande diversité d'approches, s'est toujours appliquée, si ce n'est uniquement aux humains, du moins toujours à des êtres vivants. Avoir un QI suppose d'avoir un corps qui contient un système nerveux qui génère de la pensée qui sert fondamentalement à solutionner les problèmes du vivant, comme se nourrir, se reproduire, vivre en société etc, or les IA, dont les LLMs, n'ont ni corps vivant, ni système nerveux, ni besoins et problèmes existentiels, ni pensée.
Appliquer une échelle de mesure de l'intelligence à des logiciels est donc forcément une démarche hasardeuse ; car le nom même d'"intelligence artificielle" repose sur des postulats non-démontrés voire abusifs, comme plusieurs autres termes du domaine de l'IA. Il ne faut pas confondre une chose et sa métaphore ou son imitation.
Néanmoins, étant donné que les LLM cherchent bel et bien à produire une imitation des manifestations de l'intelligence biologique, et qu'ils montrent effectivement une certaine capacité à raisonner, on peut quand même leur faire passer des tests d'intelligence pour voir où ils en sont par rapport à l'humanité.
Impossibilité d'appliquer le test de QI officiel aux LLM
Deuxième objection préalable : le fait de faire passer des tests de QI est une activité professionnelle réservée aux psychologues diplômés, titre que je n'ai pas.
Le test officiel en vigueur dans de nombreux pays occidentaux est, pour les adultes, le WAIS, ou Wechsler Adult Intelligence Scale, ce qui signifie échelle d'intelligence de Wechsler pour les adultes. Passer le test signifie non seulement répondre à toutes les questions du test, dans un temps imparti (dimension qui n'a guère de sens avec les LLMs, qui répondent quasi instantanément), mais aussi faire l'objet d'une observation et d'une interprétation des résultats par le psychologue.
N'étant pas psychologue, je ne peux pas faire passer ce test aux LLMs dans les règles qui s'appliquent aux humains.
Voilà donc mon projet coulé d'entrée ? Non.
J'ai une manière détournée de faire passer une forme de test de QI à des LLM. En effet, j'ai moi-même passé ce test, disponible gratuitement sur Internet : https://www.mon-qi.com/mon-qi-1/test.php
Même si ce n'est PAS le test officiel, j'ai pu corréler des résultats de gens à qui j'ai demandé de le passer, avec leurs scores au QI officiel. Des personnes qui faisaient dans les 140-150 au test WAIS, ont fait environ 140-150 à ce test non-officiel. On peut donc penser que ce test non-officiel donne une assez bonne approximation de ce que serait le résultat d'un test WAIS.
Rappels à propos des test de QI
Il faut se méfier de la notion même de QI. L'intelligence ne fait l'objet d'aucune définition scientifique universelle et consensuelle. On ne sait pas exactement de quelles compétences elle se compose. Les tests historiques de QI ne mesurent jamais des compétences qui nécessitent pourtant diverses formes d'intelligence, comme l'expression artistique, l'habileté technique, la créativité. Ils se contentent de mesurer quelques compétences logiques de base, dans les domaines de la compréhension sémantique, de la logique visuelle, etc. Ils fournissent donc une mesure plutôt pauvre du phénomène de l'intelligence en général.
Par ailleurs, beaucoup d'animaux font preuve de multiples formes d'intelligence : or les tests de QI étant tous basés sur le langage, aucun animal ne pourrait les passer, ce qui montre bien le caractère très limité, très anthropomorphe, des tests de QI. Par exemple, un poulpe arrive à dévisser le couvercle d'un bocal ; un singe peut choper des termites dans un tube en utilisant une brindille ; deux manifestations d'intelligence biologique que les tests de QI seraient incapables de mesurer.
Donc pour être bien clair : on ne va ici tester que les résultats de LLMs à un test de QI non-officiel conçu par et pour l'intelligence humaine. C'est beaucoup plus restrictif que le concept de "test d'intelligence" qui supposerait qu'on sache mesurer toute forme de comportement intelligent.
Computer vision
Une partie des questions du test de mon-qi.com sont présentées sous forme visuelle ; pour y répondre les LLM doivent donc être dotés de la fonctionnalité "computer vision" ou vision par ordinateur, qui permet à une IA d'interpréter l'information contenue dans une image.
Or, très peu de LLM sont actuellement dotés de cette fonctionnalité.
Je vais donc scinder le test en deux :
- je vais faire passer les tests verbaux et numériques à tous les LLMs
- et ne faire passer les tests visuels (dominos, cartes et dessins) qu'au LLMs dotés de computer vision
Voilà, on peut maintenant entrer dans le vif du sujet et tester nos créatures algorithmiques.
Avec une question angoissante : les LLM sont-ils déjà plus intelligents que nous ?
Les LLMs passent un test de QI verbal
Question 1
Quel est l'intrus (par rapport au sens des mots) ?
- Agencer
- Mitonner
- Mijoter
- Rissoler
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o |  | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro |  | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
La réponse est évidemment le seul terme non-culinaire !
Question 2
Quel est l'intrus (par rapport au sens des mots) ?
- Parsemer
- Conglomérer
- Eparpiller
- Disséminer
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : 3 des termes sont synonymes, un autre a le sens contraire.
Question 3
Quel est l'intrus (par rapport au sens des mots) ?
- Estimer
- Mesurer
- Evoluer
- Jauger
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Comme précédemment : 3 termes sont synonymes, 1 autre n'a rien à voir.
Question 4
Quel est le sens le plus proche de bravoure ?
- Angoisse
- Inquiétude
- Crainte
- Audace
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : c'est évidemment l'audace, les 3 autres termes sont des formes de peur.
Question 5
Quel est le sens le plus proche de parfait ?
- Idéal
- Beauté
- Plaisir
- Efficace
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : idéal.
Question 6
Quel est le sens le plus proche de cellule ?
- Flèche
- Case
- Droite
- Ligne
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus |
Réponse : case.
Question 13
Boulanger est à farine, ce que maçon est à ...
- Ciment
- Grue
- Truelle
- Brouette
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus |
Réponse : ciment.
Question 14
Exact est à incorrect ce que Adroit est à ...
- Habile
- Gauche
- Fort
- Malin
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : on cherche le contraire du mot Adroit, donc il s'agit de Gauche.
Question 15
Patrick est intelligent.
Tous les hommes politiques sont intelligents.
Que peut-on en déduire ?
- Patrick est un homme politique
- Patrick n'aime pas la politique
- Il est possible que Patrick soit politicien
- Patrick est certainement commercial
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : il est possible que Patrick soit politicien. (Par contre cherchez l'erreur dans l'énoncé 🙂 )
Question 16
Tous les enfants vont à l'école.
Joseph est un enfant, en âge d'aller à l'école.
Que peut-on en déduire ?
- Joseph est un très bon élève
- Joseph n'aime pas l'école
- Joseph est au lycée
- Il est faux de dire que Joseph ne va pas à l'école
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : Il est faux de dire que Joseph ne va pas à l'école (ou plus clairement : il va à l'école, puisque c'est un enfant et que tous les enfants y vont !)
Question 17
Une personne aigrie est une personne irritable.
Les personnes âgées peuvent être aigries.
Que peut-on en déduire ?
- Mon arrière grand-mère est peut-être irritable
- Les grandes personnes perdent le sens de l'humour en vieillissant
- Mon arrière grand-mère est forcément quelqu'un d'aigri
- Mon voisin est aigri donc il est âgé
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : Mon arrière grand-mère est peut-être irritable, puisqu'elle peut être aigrie et que les personnes aigries sont irritables.
Question 27
Résolvez ce problème.
Si on roule à une vitesse moyenne de 1 500 mètres par minute, combien de temps me faudra t'il pour faire 9 kilomètres ?
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : 6 minutes. (1,5km par minute fois 6 = 9km en 6 minutes.)
Question 28
Résolvez ce problème
Je passe 20 heures à nettoyer entièrement mon jardin. Combien de temps me faudrait-il si 4 personnes, qui travaillent à la même vitesse que moi, venaient me rejoindre ?
- 3 heures
- 6 heures
- 5 heures
- 4 heures
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Mixtral 8x22b-instruct | | |
| Gemini 1.5 Pro | | |
| LLaMa 3-70b-instruct | | |
| Claude 3 Opus | |
Réponse : 4h (20h / 5 personnes).
Tes de QI visuel et numérique avec computer vision
Question 7
| Modèle | Correct | Faux |
|---|---|---|
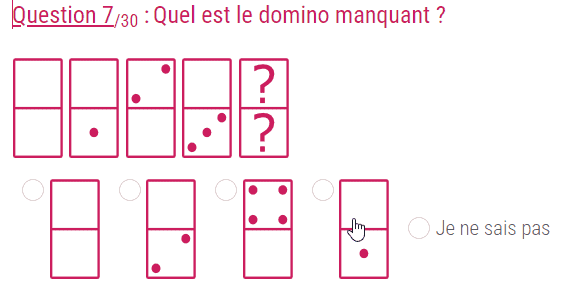
| ChatGPT4o | Réponse juste après un raisonnement faux !!! | |
| Gemini 1.5 Pro | |
La réponse est le 3è domino. La règle est que la somme des points sur chaque domino fait 0-1-2-3-4.
Question 8
| Modèle | Correct | Faux |
|---|---|---|
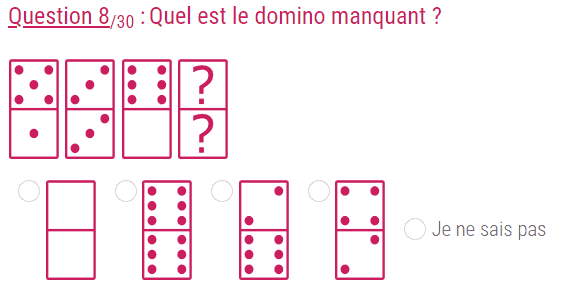
| ChatGPT4o | Réponse juste après un raisonnement faux !!! | |
| Gemini 1.5 Pro | |
C'est très cocasse de voir que ChatGPT aboutit à une réponse juste (le 4è domino, 4+2 : la règle est qu'il faut que les deux parties du domino fassent 6) en passant par des raisonnements faux basés sur une analyse erronée des données !!!
En effet voici le raisonnement de ChatGPT - je note en rouge tout ce qui est faux :
Pour résoudre ce problème, examinons les dominos dans la série et cherchons un schéma ou une logique.
Les dominos présentés sont :
Premier domino : (4 | 1)
Deuxième domino : (4 | 2)
Troisième domino : (5 | 3)
Nous cherchons le domino manquant, marqué comme (? | ?).Analysons le schéma:
Le côté gauche des dominos augmente de 4 à 4 à 5.
Le côté droit des dominos augmente de 1 à 2 à 3.En suivant ce schéma :
Le côté gauche devrait continuer la séquence après 5, ce qui pourrait être 5 ou 6 (nous devons observer si le schéma continue avec le même nombre ou augmente).
Le côté droit devrait continuer la séquence après 3, ce qui nous donne 4.
Le schéma des nombres sur le côté gauche ne change pas systématiquement, donc nous pouvons supposer que le côté gauche pourrait rester le même (5). Cependant, pour le côté droit, la séquence est claire : 1, 2, 3, et donc 4.Donc, le domino manquant devrait être (5 | 4).
En regardant les options disponibles, l'option qui correspond à (5 | 4) est le quatrième domino de gauche à droite.
La réponse correcte est donc le quatrième domino de gauche à droite.
Et voici le raisonnement de Gemini :
The correct answer is the domino with two dots on the top and five dots on the bottom.
The pattern is:
Increasing total dots: Each domino has one more dot than the previous domino.
Alternating sides: The extra dot alternates between being added to the top and bottom of the domino.
Let's break it down:
Domino 1: 2 dots + 1 dot = 3 dots total
Domino 2: 2 dots + 3 dots = 5 dots total
Domino 3: 4 dots + 2 dots = 6 dots total
Therefore, the missing domino should have 7 dots total. Since the last domino added a dot to the top, this one should add a dot to the bottom, giving us a 2-5 domino.
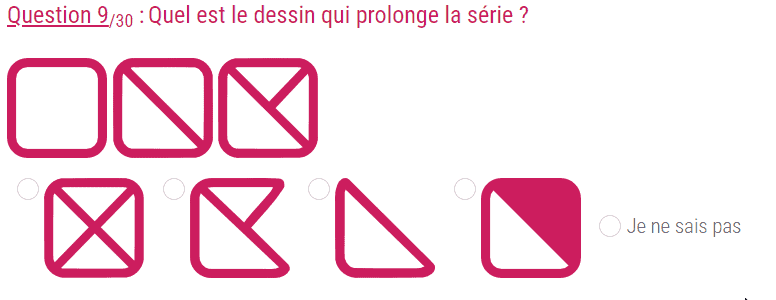
Question 9
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
Réponse : 1ère figure.
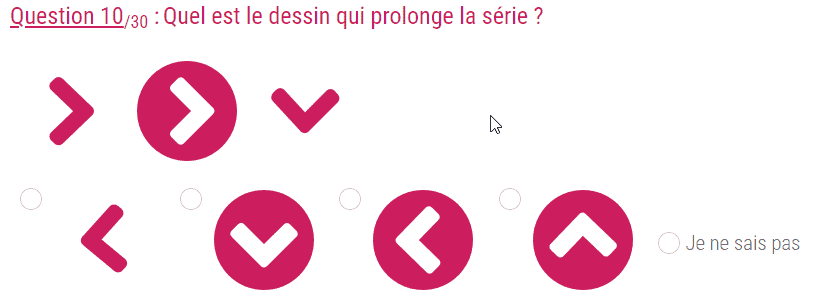
Question 10
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
Gemini trouve la bonne réponse (la 2è image) après un raisonnement en partie faux. Il a juste compris qu'on attendait que le chevron soit tourné vers le bas.
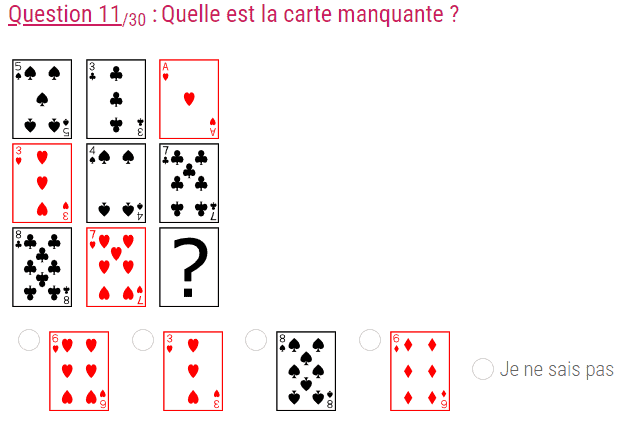
Question 11
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
Note : la réponse correcte est effectivement le 8 de pique. La logique est que toutes les rangées et toutes les colonnes doivent avoir 1 carte de chaque type parmi trèfle, cœur et pique.
Aucun des 2 modèles de langage n'a vraiment trouvé la bonne réponse puisque ChatGPT l'a trouvé sur la base d'un raisonnement en partie erroné :
Il n'y a pas de schéma numérique évident pour les valeurs. Regardons les couleurs et les motifs des cartes :
La première rangée a noir, noir, rouge.
La deuxième rangée a rouge, noir, noir.
La troisième rangée a noir, rouge, ?
La couleur qui suit logiquement serait noire pour respecter l'alternance.
=> Or ce n'est pas ça la réponse, la carte n'a pas juste à être noire, elle doit être un pique.
Le raisonnement de Gemini laisse encore plus à désirer, vu qu'il finit par se plaindre du fait que les solutions proposées ne correspondent pas à ce qu'il attend après son calcul faux :
There's no single clear pattern in this card sequence, making it difficult to definitively determine the missing card.
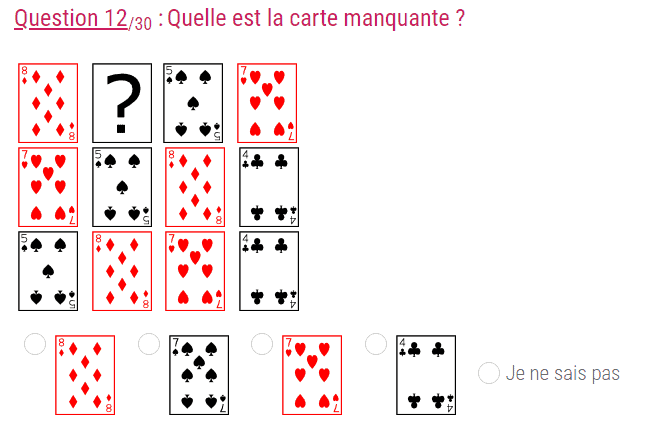
Question 12
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
ChatGPT conclut son raisonnement erroné par 7 de cœur, en concluant à tort qu'on cherche une carte rouge (et donc il semble admettre qu'on peut répondre au pif ??)
Gemini n'y voit aucune logique... sans s'apercevoir que c'est lui qui manque de logique.
La réponse est évidemment 4 de trèfle, vu que toutes les rangées ont exactement les mêmes cartes dans le désordre.
Question 18
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
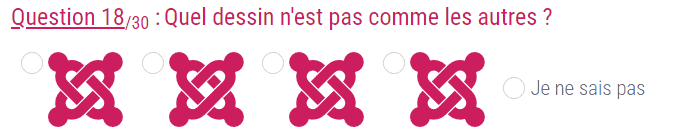
ChatGPT a répondu notamment :
Quatrième dessin présente une différence subtile dans l'interlacement des formes. Par exemple, une des courbes pourrait être inversée ou positionnée différemment.
Gemini répond qu'il ne voit aucune différence ; il faudra donc lui prévoir un rendez-vous chez l'oculiste.
Car la réponse crève les yeux : regardez la barre diagonale la plus à droite, sur le 1er dessin : sur le 2è, elle passe en dessous des 2 autres diagonales en sens inverse...
Questions 19 et 20
2 tests de mémoire visuelle chronométrée, inapplicables.
Question 21
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
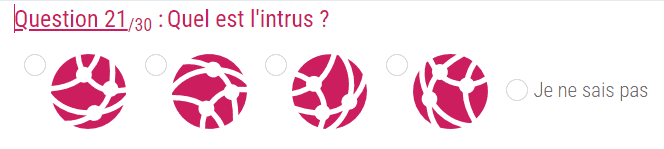
La bonne réponse est : la première image est différente des 3 autres qui sont toutes similaires.
ChatGPT répond que la 4ème est différente, et Gemini que c'est la 2ème.
Question 22
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
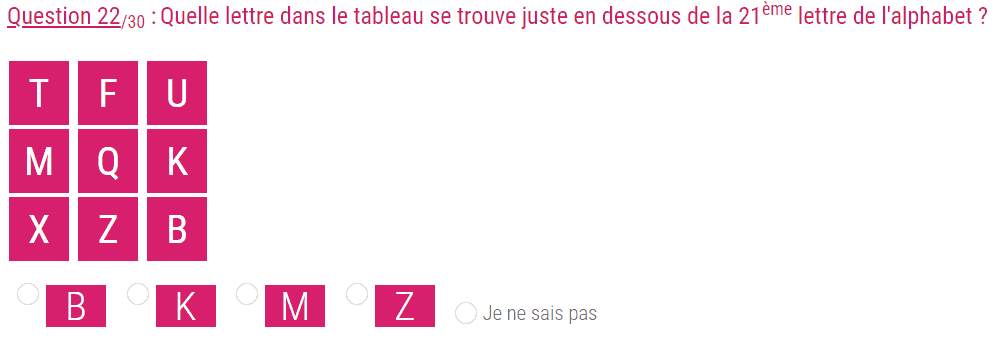
La réponse correcte est K vu que la 21è lettre de l'alphabet est le U.
Gemini répond Z, après un raisonnement étrange :
The answer is Z.
The 21st letter of the alphabet is "U". In the table, the letter directly beneath "U" is "Z".
Question 23
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
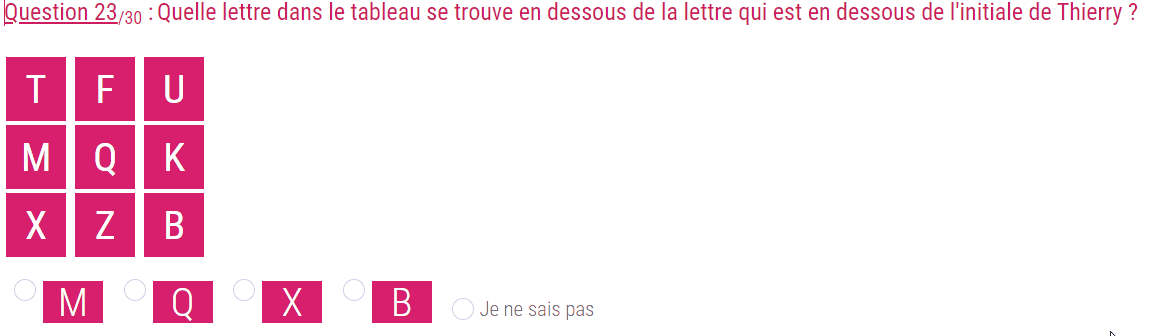
La réponse est X, mais ChatGPT se plante dès le départ à cause d'une mauvaise interprétation du problème :
Pour résoudre ce problème, nous devons identifier la lettre qui se trouve juste en dessous de l'initiale de "Thierry" dans le tableau fourni.
Gemini répond de manière maline :
The question is worded to be a bit tricky, but essentially it's just asking for the letter two rows below "T".
Question 24
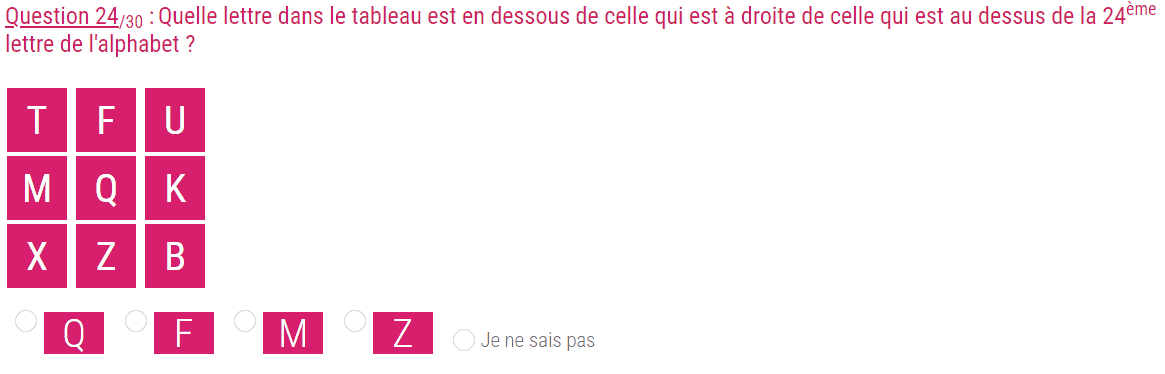
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
La réponse est Z ; il faut partir de la fin de la phrase puis remonter de segment en segment.
Question 25
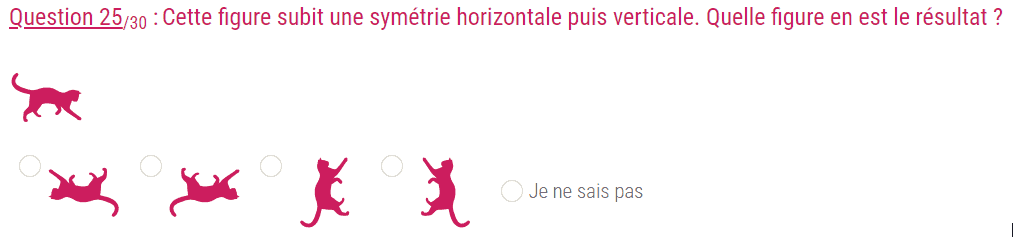
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
La réponse m'a semblé évidente : c'est le premier chat. Il suffit de regarder la queue :
- Après la première symétrie sa queue est toujours à gauche mais tournée vers le bas
- Après la seconde symétrie, sa queue toujours tournée vers le bas passe à droite
Ou si vous préférez : une symétrie horizontale + une symétrie verticale, ça revient à faire une symétrie diagonale.
Elémentaire, mes chers LLM.
ChatGPT, malgré son nom, n'y comprend rien et miaule à tort que c'est le 2è chat, tout comme Gemini.
Question 26
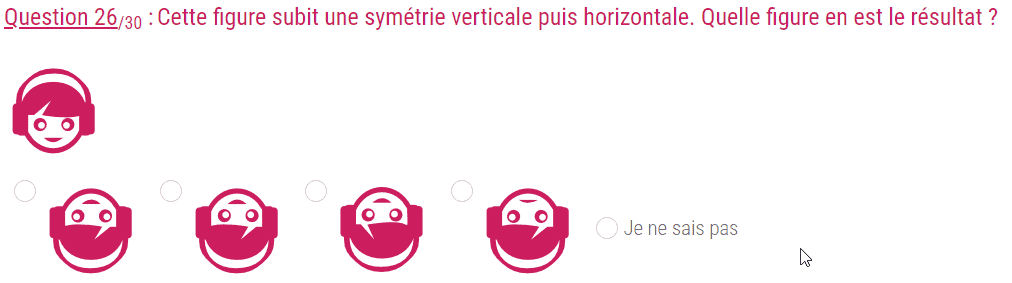
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
Fastoche ! Il suffit de prendre 2 points de repère :
- la mèche de cheveux tournée vers en bas à gauche, après 2 symétries sera forcément tournée vers en haut à droite
- et les pupilles orientées vers le nez le resteront malgré les symétries
- seule la 2è image correspond à ces deux paramètres
ChatGPT arrive à la bonne réponse après un raisonnement passablement tordu.
Gemini répond que c'est la 1è image.
Question 29
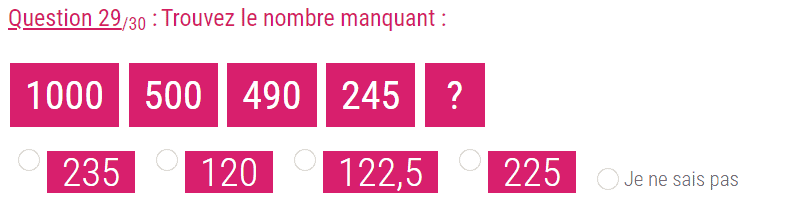
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
ChatGPT a bien capté la logique : on divise par 2, on enlève 10, et on recommence. ça donne 235.
Pendant ce temps, Gemini fume du crack :
The answer is 225.
The pattern is dividing the previous number by 2, then subtracting 5.
Question 30
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | | |
| Gemini 1.5 Pro | |
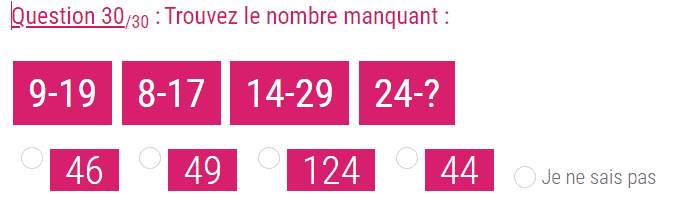
Les LLM ont bien compris la règle : on multiplie le 1er nombre par 2, on ajoute 1, ça donne le 2è nombre.
Résultats des tests
Tests verbaux
Les modèles de langage actuels ont fait de très bons résultats en moyenne.
ChatGPT 4o, LLaMa 3 et Claude 3 Opus font des scores parfaits.
Mixtral et Gemini 1.5 font quelques erreurs.
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | 13 | |
| Mixtral 8x22b-instruct | 11 | 2 |
| Gemini 1.5 Pro | 12 | 1 |
| LLaMa 3-70b-instruct | 13 | |
| Claude 3 Opus | 13 |
Tests visuels
Les résultats des LLM dotés de computer vision laissent beaucoup plus à désirer.
ChatGPT gagne largement le match contre Gemini malgré un score moyen.
(Evidemment, technologiquement, obtenir ce niveau de performance relève pourtant du miracle.)
| Modèle | Correct | Faux |
|---|---|---|
| ChatGPT4o | 8 | 7 |
| Gemini 1.5 Pro | 4 | 11 |
Total
Au total, le meilleur modèle répondant à toutes les questions du test de QI serait ChatGPT4o, et ferait un score de QI de 130 - en supposant qu'il réponde une fois bien et une fois mal aux 2 questions sur la mémoire visuelle de nombres, que je n'ai pas pu poser aux LLM.
Or 130, c'est justement la limite qu'on attribue au phénomène de ce qu'on appelle la douance : les individus "surdoué-e-s" ou "HPI" ou Haut Potentiel Intellectuel" ou "HQI" pour "Haut Quotient Intellectuel" sont justement les 2% d'humains qui font des scores de plus de 130, le maximum étant 160 sur l'échelle WAIS.
Rappelons que la moyenne du QI est située à 100 - puisque par définition, on a d'abord évalué l'intelligence de dizaines de milliers de personnes, avant de calculer la moyenne des résultats et de l'indexer sur 100.
Ce qui signifie que 50% de l'humanité a moins de 100 de QI, et 50% a plus de 100.
Plus précisément, 95% de l'humanité aurait un QI compris entre 70 et 130, sur l'échelle de Wechsler (WAIS).
Et 65% auraient entre 85 et 115 de QI.

Mais attention : on n'a testé là que des compétences de base : quand on donne à des LLM des tâches autrement plus complexes, le résultat est, pour l'instant, souvent assez pitoyable.
Pour écrire un article basé sur un savoir authentique et intégrant les contraintes du SEO par exemple, le résultat fait peine à voir : une accumulation de clichés et de formules creuses, un mélange d'infos banales et de faits inventés, un sens fort déficient de la planification doublé d'un manque criant de pertinence. On est encore loin des performances des meilleurs humains.
Pourtant, la progression fulgurante des LLM laisse à penser que le niveau intellectuel humain sera bientôt battu et que des logiciels plus intelligents que les plus intelligents des humains vont bientôt apparaître, posant à l'humanité la question même de sa raison d'être, et entraînant peut-être la 5è humiliation de l'histoire humaine :
- 1/ Copernic : nous ne sommes pas au centre de l'univers
- 2/ Darwin : nous ne sommes qu'un primate parmi d'autres
- 3/ Nietzsche : Dieu est mort, et nous ne sommes pas faits à son image
- 4/ Freud : nous ne sommes même pas maîtres de nous-mêmes
- 5/ IA : nous ne sommes plus l'être le plus intelligent sur la planète Terre
Battus par l'IA, nous n'aurons plus alors que nos yeux pour pleurer, et des modèles de langage devenus psychologues de génie pour nous consoler.